Traduction de Slop, productivity, and why the AI-fueled world is going nowhere mighty fast par Gary Marcus, Marcus on AI sur Substack le 7 juin 2026
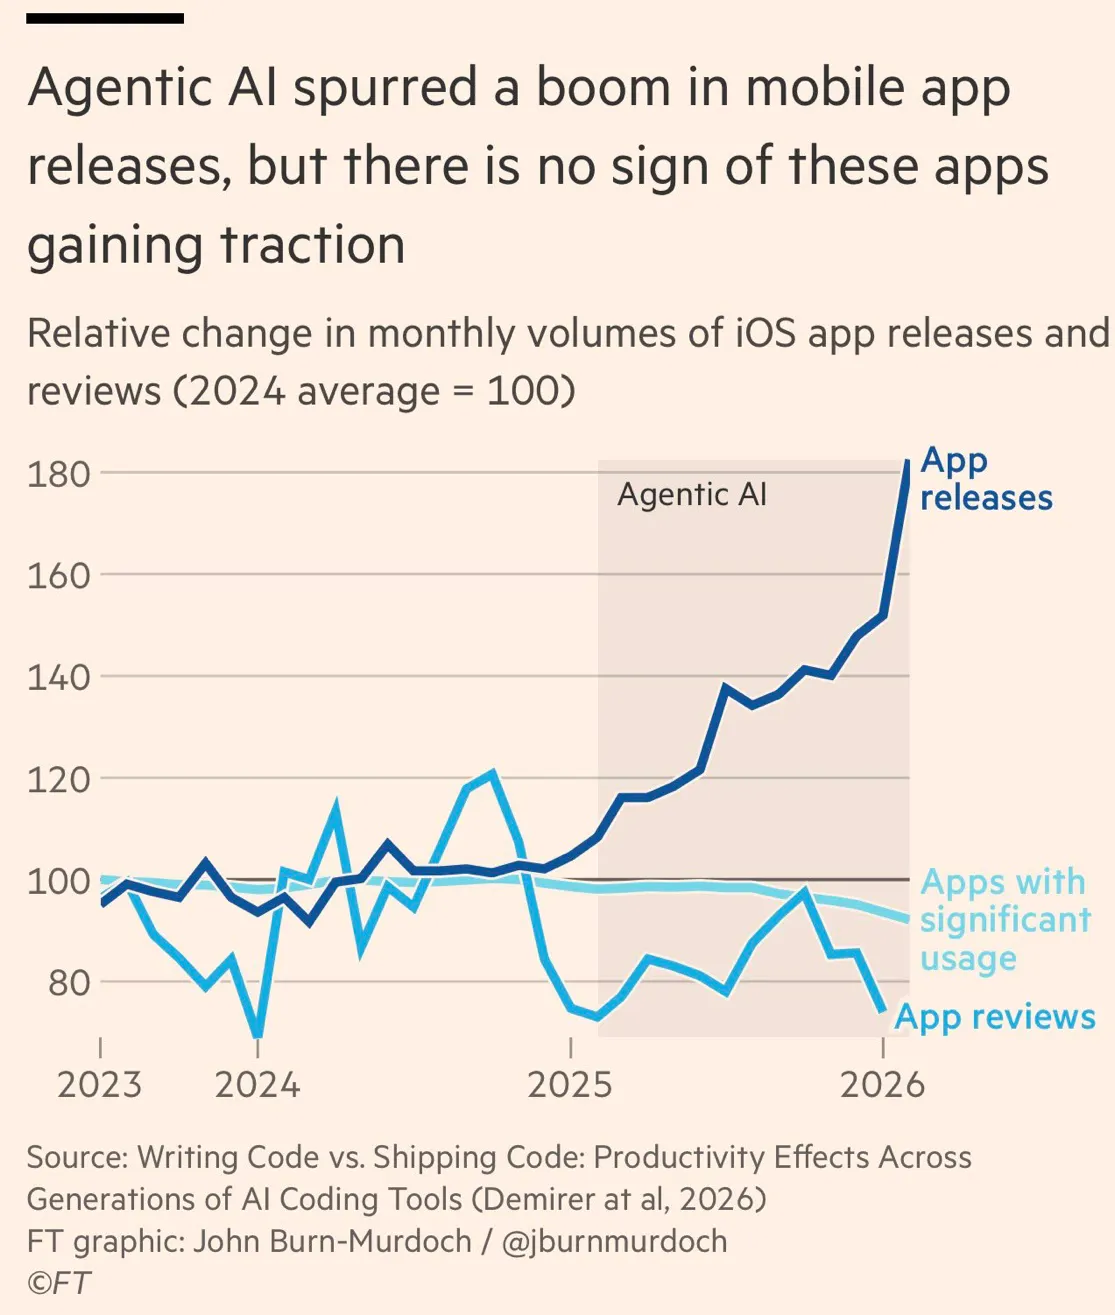
Je viens de voir un graphique publié dans le FT par John Burn-Murdoch qui résume parfaitement ce que j’essayais d’exprimer. L’IA génère un volume de production important (ce qui correspond à la notion informelle de productivité qu’ont beaucoup de gens), mais elle n’a pas généré un retour sur investissement significatif pour de nombreuses entreprises (selon des études du MIT, de McKinsey, de Bain et de bien d’autres), et n’a pas modifié de manière significative le PIB.
Ce graphique du FT porte justement sur les applications mobiles (merci à Jen Zhu). Mais on pourrait créer des graphiques similaires dans de nombreux domaines : une productivité nominale énorme, mais peu d’impact concret.
On pourrait, par exemple, dire quelque chose de similaire à propos des livres. L’IA générative a donné lieu à beaucoup plus de livres, mais il n’est pas certain qu’il s’agisse de meilleurs livres ni (désolé, je n’ai pas les données sous la main) que les ventes aient augmenté. Voici le nombre de livres disponibles au fil du temps, tiré du Washington Post :
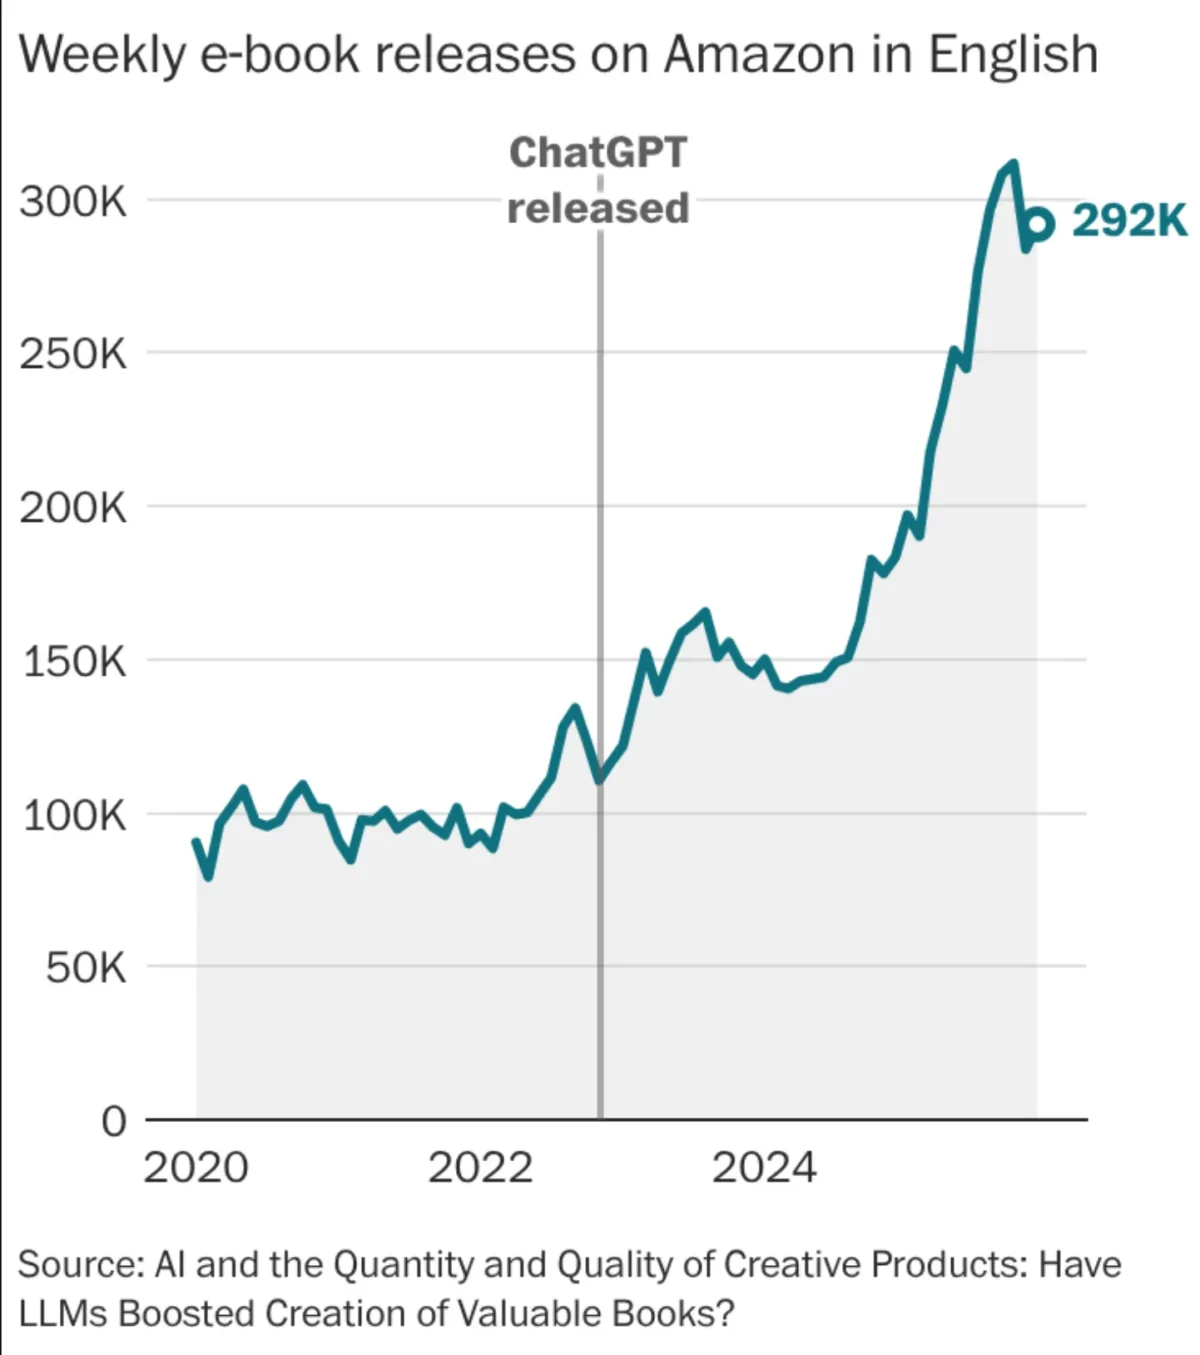
Les ventes de livres, en revanche, ont légèrement diminué au cours de la même période. Et je n’entends personne affirmer que les livres sont de meilleure qualité.
L’article du Post dont j’ai tiré les informations ci-dessus présentait des graphiques similaires concernant l’augmentation du nombre de morceaux de musique mis en ligne, de poursuites judiciaires intentées sans avocat, d’articles scientifiques soumis et de contenu Web généré.
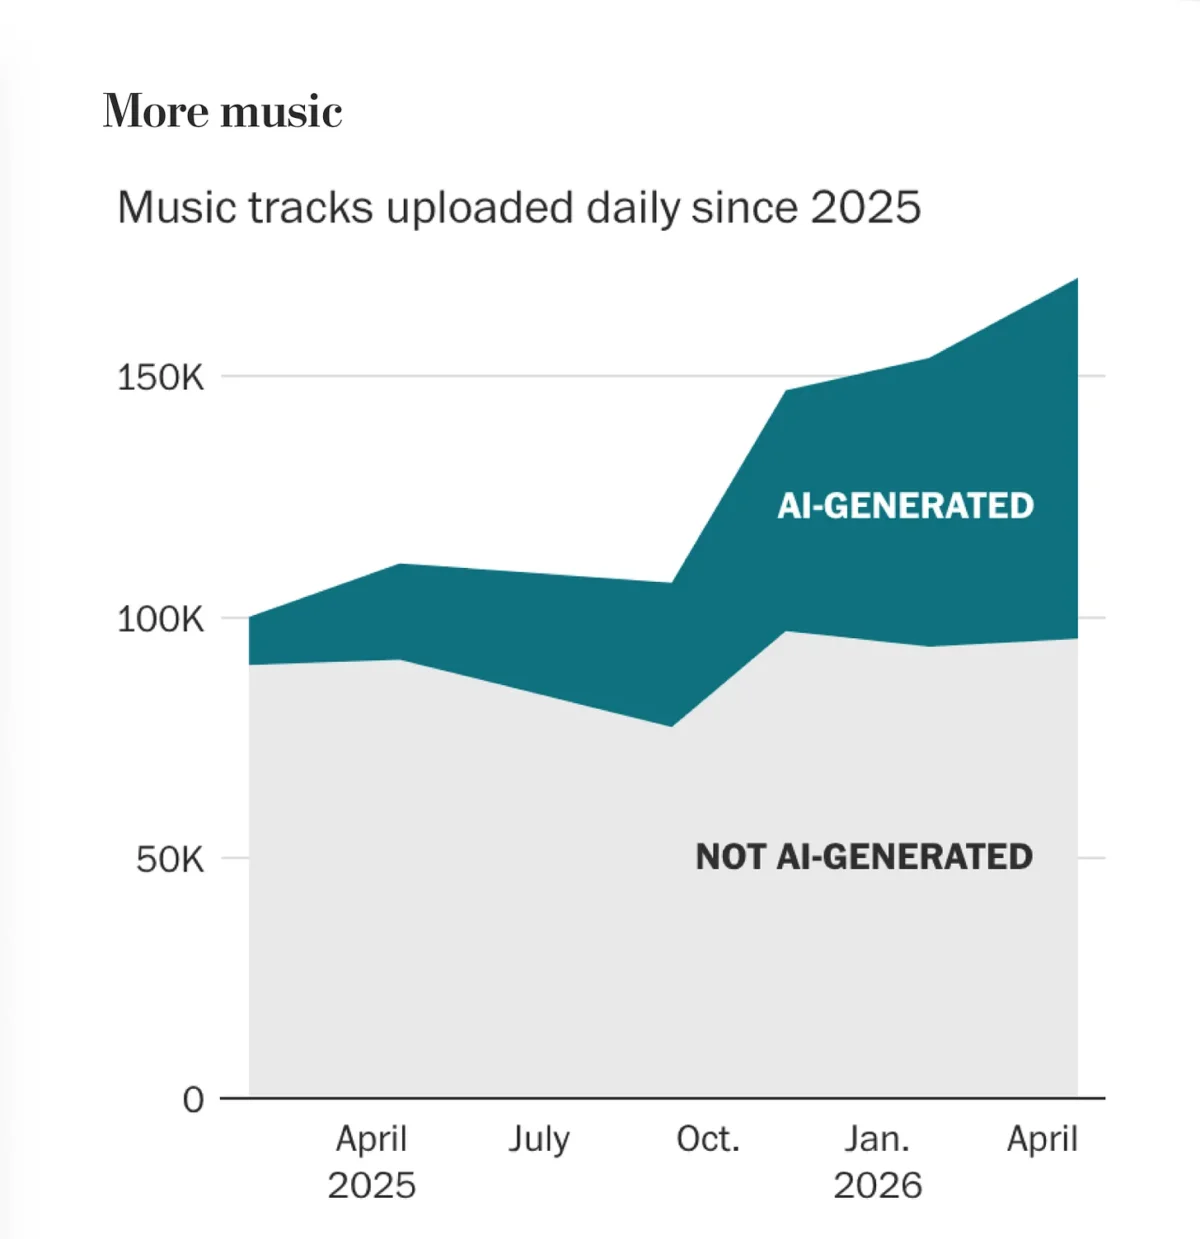
Encore une fois, il n’y a aucune raison de penser que tout cela ait contribué au PIB ou à la qualité de la science ou de la musique. La plupart de ces contenus sont de la camelote (et dans certains cas, de la camelote professionnelle) :
Les graphiques du FT et du Washington Post montrent sans cesse la même chose : nous sommes submergés par du contenu généré par l’IA, des applications à la musique en passant par les articles scientifiques, mais cela ne rend rien de tout cela meilleur. La plupart de ces contenus (pour être honnête, pas tous) ne le sont pas.
Et puis il y a les contenus de mauvaise qualité qui inondent Wikipédia, les bibliothèques et ainsi de suite.
Il est très probable que la même chose se produise en mathématiques. Un groupe de mathématiciens, inquiets de nombreux aspects de l’impact de l’IA sur la recherche mathématique, a rédigé une lettre ouverte intitulée « Déclaration de Leyde », rapportée par le NYT, exprimant (entre autres préoccupations) leur crainte que
Les techniques automatisées actuelles peuvent produire des arguments plausibles mais peu fiables (voire incorrects) qui sont difficiles à distinguer des preuves mathématiques correctes. Cela s’applique non seulement aux arguments informels, mais aussi aux formalisations, où la difficulté réside dans la traduction entre les représentations informatiques et humaines des concepts. Ces développements rapides exercent une pression croissante sur notre système actuel d’évaluation, compromettant notre capacité à appliquer les normes traditionnelles en matière d’exactitude, de transparence et de vérifiabilité indépendante des preuves.
En d’autres termes, du charabia mathématique.
Il n’y a pas si longtemps, alors que je réfléchissais aux mesures officielles de la productivité et à la question de savoir si elles changeraient avec l’IA, un ami investisseur m’a écrit pour me rappeler à quel point la définition technique de la productivité par rapport au PIB est étroite, en notant que « dans le monde technique de la comptabilité nationale, payer des gens pour creuser et reboucher des trous contribue au PIB ».
L’utilisation de l’IA générative fait grimper les coûts en jetons et inonde le monde de contenu. Mais trop souvent, ce contenu — créé par une gigantesque machine de prédiction de mots peu fiable, plus régurgitative qu’innovante — n’a que peu de valeur durable.
Peut-être que la plus grande exception est le codage, mais même là, on ne sait pas encore clairement combien de systèmes créés à l’aide du codage agentique perdureront.
§
De plus, en particulier dans le codage agentique, il y a des pertes massives, tout au long de la chaîne alimentaire. Les fournisseurs (OpenAI, Anthropic, Cursor, etc.) perdent des sommes colossales et s’empressent d’augmenter leurs prix, tandis que les clients rechignent à adopter les nouveaux modèles d’utilisation. (Dans une nouvelle analyse, Gerben Wierda a fait valoir qu’Anthropic et OpenAI « pourraient en réalité payer 1 000 $ pour chaque tranche de 100 $ que vous leur versez ». Les intermédiaires de centres de données comme CoreWeave perdent également de l’argent. Il est même difficile de dire comment se portent les fabricants de puces, une fois pris en compte le financement circulaire et la diminution des flux de trésorerie. Le seul secteur où l’on pourrait parler de gains de productivité significatifs (le codage) est aussi celui qui brûle le plus d’argent.
Il se pourrait bien qu’une fois que les fournisseurs (OpenAI, Anthropic, Cursor, etc.) tenteront de facturer suffisamment pour couvrir leurs pertes, le coût de l’IA devienne plus élevé que celui des humains qu’elle remplace.
C’est ce qu’on appelle creuser des trous sans créer de valeur réelle.
P.S. Voir aussi Paul Krugman et Paul Kedrosky pour de nouveaux articles arrivant à des conclusions quelque peu similaires, sous des angles différents.
P.P.S. À propos d’un tweet d’hier, sans doute en partie ironique :