
Critiques et partisans cherchent tous deux au mauvais endroit
Traduction de Up the Stack: How AI’s Escape From the Commodity Trap Risks Enterprise Lock-in par Arvind Narayanan et Akash Kapur, sur Substack, le 9 juillet 2026.
Notre objectif dans cet essai est d’aller au-delà du débat visant à déterminer si l’IA est une bulle. Nous procédons de deux façons : en séparant clairement les données financières actuelles de la question de savoir qui capte la valeur à long terme, et en reconnaissant que les laboratoires ne se limitent pas à être de simples fournisseurs de modèles. Ils peuvent remonter la chaîne de valeur et s’y emploient déjà avec détermination. Cela leur permettra probablement d’échapper au piège de la banalisation, mais soulève de nouvelles préoccupations : le verrouillage des clients et la réduction de la concurrence.
Akash Kapur est chercheur invité à Princeton et chercheur principal à New America. Il n’a aucun lien de parenté avec Sayash Kapoor.
Alors que les principales entreprises d’IA continuent d’investir massivement dans leurs capacités et se précipitent vers des introductions en bourse spectaculaires, de sérieuses questions subsistent quant à leurs modèles d’affaires. Comment ces entreprises — ainsi que le vaste écosystème de fabricants de puces, d’hyperscalers et de partenaires d’infrastructure qui dépendent d’elles — récupéreront-elles les 4 à 8 billions de dollars qui, selon les estimations, devraient être investis dans l’infrastructure d’IA d’ici le début des années 2030?
Le débat actuel oppose les détracteurs aux partisans. Les détracteurs soulignent les pertes croissantes, l’écart entre les dépenses en immobilisations et les revenus, ainsi que les rapports faisant état d’une consommation massive de liquidités par les principaux laboratoires. Les partisans mettent en avant la croissance rapide et accélérée des revenus, l’adoption par les entreprises et des jalons tels que le premier trimestre rentable d’Anthropic. Chaque camp a des arguments valables. Mais les deux cherchent au mauvais endroit : les mêmes rapports trimestriels, la même vision à court terme d’un secteur qui reste en pleine évolution.
Au cours des derniers mois, nous avons réfléchi à la nature et à la viabilité du secteur de l’IA, et nous en sommes arrivés à une conclusion différente de celle de la plupart des analyses existantes. Aujourd’hui, les entreprises d’IA tirent une grande partie de leurs revenus de la facturation des services d’inférence, mais les conditions qui régissent l’inférence de pointe rendent ce modèle d’affaires exceptionnellement difficile à maintenir. Les modèles sont largement indifférenciés, les principaux laboratoires fonctionnent avec des structures de capital similaires, les coûts de changement sont faibles et les prix peuvent être ajustés librement. Tout cela semble créer les conditions d’un piège de la banalisation qui poserait de réels défis à la création d’entreprises à forte marge, voire rentables.
Parallèlement, nous estimons que le secteur se trouve encore dans une phase de transition et que sa structure sera très différente lorsqu’il aura atteint sa maturité. En nous appuyant à la fois sur des données historiques et sur la théorie économique, nous soutenons que la concurrence dans cet équilibre est susceptible de faire baisser le prix de l’inférence des modèles vers le coût marginal de production des jetons, laissant peu de place à des profits durables au niveau de la couche des modèles. Cela ne signifie toutefois pas que le secteur de l’IA soit intrinsèquement non viable. Cette même analyse suggère une voie à suivre pour les laboratoires d’IA et nous amène à l’argument central de notre article :
La voie la plus probable vers une rentabilité durable pour ces laboratoires ne passe pas par les couches de base (puces, centres de données, modèles) qui ont jusqu’à présent représenté l’essentiel des investissements, mais plus haut dans la pile, grâce à une combinaison d’intégration verticale, de déploiements intégrés dans les entreprises et à la création délibérée de coûts de changement et d’autres « fossés ».
Les stratégies des laboratoires visant à capter de la valeur en remontant dans la pile, dont beaucoup s’inspirent du modèle des logiciels d’entreprise, ont déjà commencé. Au-delà de la viabilité de l’écosystème actuel de l’IA, elles soulèvent des questions d’intérêt sociétal plus large — concernant la concurrence, l’innovation et la répartition globale du pouvoir économique et politique. Le débat public sur l’IA a jusqu’à présent été marqué par une dichotomie quelque peu paradoxale : d’un côté, l’inquiétude face à la concentration monopolistique et à un pouvoir de marché incontrôlable; de l’autre, une réalité caractérisée par de faibles coûts de transfert et des modèles relativement interchangeables qui semblent contredire ces craintes. Mais si nous avons raison de penser que les laboratoires vont de plus en plus remonter la chaîne technologique, alors les préoccupations relatives à la concentration et à la concurrence méritent d’être prises au sérieux dès maintenant, plutôt qu’une fois que les effets de l’enfermement commenceront à se concrétiser. Nous reviendrons sur ces enjeux plus larges dans la conclusion — ainsi que dans un article à paraître qui approfondira bon nombre des sujets abordés dans ce billet.
Analyse historique : la couche d’infrastructure échoue massivement à capter la valeur qu’elle crée
Le cadre « L’IA comme technologie normale » s’attache à tirer des leçons, le cas échéant, des technologies transformatrices du passé. Nous pensons que l’IA est soumise à bon nombre des mêmes dynamiques liées à l’investissement, à la concurrence et à la capture de valeur qui ont façonné les vagues précédentes d’innovation technologique. Dans le cadre de nos recherches, nous avons donc examiné l’énigme de la capture de valeur de l’IA, ainsi que la réponse probable des laboratoires à ce phénomène, à travers un prisme historique plus large.
Nous avons examiné six exemples historiques de secteurs d’infrastructure à forte intensité de capital (chemins de fer, électricité, télécommunications et fibre optique, informatique en nuage, fabrication de semi-conducteurs et aviation commerciale). Nous estimons que l’IA présente aujourd’hui de nombreuses caractéristiques propres aux infrastructures : des besoins en capital considérables; un coût marginal faible; un produit de base quelque peu dissocié des applications qui, en fin de compte, créent de la valeur. Cela fait des infrastructures un secteur d’activité réputé pour être particulièrement difficile.
Mais en même temps, l’IA est un logiciel, et le secteur des logiciels s’est historiquement révélé lucratif, avec des marges exceptionnellement élevées. L’industrie nourrit des ambitions en matière de marges propres aux logiciels. Nous avons donc également examiné les stratégies de valeur ajoutée et de fidélisation de la « logiciel-en-service » (SaaS), et analysé si l’IA pouvait les reproduire. Notre thèse est que la pérennité et la capture de valeur des entreprises d’IA dépendent en grande partie de leur capacité à passer avec succès d’un premier ensemble de caractéristiques infrastructurelles à un second ensemble de caractéristiques propres aux logiciels d’entreprise.
De manière générale, notre analyse historique nous a permis de dégager trois leçons instructives pour l’IA. Premièrement, les fournisseurs d’infrastructure capturent rarement la valeur qu’ils créent. Que ce soit dans les secteurs des chemins de fer, de l’électricité, des télécommunications ou des compagnies aériennes, les entreprises qui ont développé des capacités ont fini par être confrontées à la concurrence, soumises à la réglementation ou transformées en produits de base, ce qui a réduit leurs marges à un niveau minime. Dans bien des cas, elles ont tout simplement disparu. Lors du déploiement des réseaux de télécommunications et de fibre optique à la fin des années 1990, la capacité a explosé de 186 000 fois en sept ans, les prix se sont effondrés et environ 2 billions de dollars de capitalisation boursière ont été anéantis. La valeur générée par l’infrastructure a principalement profité aux industries et aux applications qui s’y sont développées. L’aviation commerciale a anéanti le capital des investisseurs pendant huit décennies, car les marges nettes typiques se situent entre 2 et 4 %, souvent en dessous du coût du capital — alors même que des entreprises de tous horizons ont profité d’une économie mondialisée.
Nous estimons que l’IA, du moins sous sa forme actuelle d’« hyperscaler », risque de tomber dans le même piège de la banalisation qui a tourmenté tant de bâtisseurs d’infrastructures avant elle. Carlota Perez a théorisé ce phénomène paradoxal selon lequel les bâtisseurs qui créent des infrastructures pendant la « période d’installation » survivent rarement assez longtemps pour capter la valeur qu’elles génèrent.
Deuxièmement, les logiciels d’entreprise ne suivent pas ce schéma et échappent à ce piège grâce à un ensemble de mécanismes spécifiques et reproductibles. Là où les entreprises d’infrastructure ont connu des difficultés, les logiciels d’entreprise ont maintenu des marges brutes de 75 % ou plus pendant des décennies. Ils y parviennent en combinant trois propriétés qui font défaut aux entreprises d’infrastructure : un coût marginal de reproduction nul, des coûts de changement élevés et une valeur non éphémère qui permet d’amortir les coûts fixes de mise en place sur plusieurs décennies. Les stratégies de verrouillage des laboratoires d’IA s’expliquent surtout comme des tentatives d’importer ces propriétés structurelles des logiciels dans l’IA.
Enfin, deux exceptions partielles révèlent ce qu’il faudrait pour que l’IA défie les tendances historiques. Deux secteurs d’infrastructure — le cloud computing et la fabrication de puces — ont réussi à échapper au piège des produits de base. Le cloud a acquis des propriétés propres aux logiciels (fidélisation par les services gérés, frais de sortie, ententes d’engagement de dépenses) et TSMC a atteint une position de quasi-monopole dans la fabrication de pointe. Ces exemples sont importants, car ils montrent ce qu’il faut réellement pour échapper au piège des produits de base. Les industries à forte intensité de capital peuvent maintenir des marges durables, mais uniquement en devenant fonctionnellement des logiciels ou en parvenant à une concentration du marché.
Pourquoi nous pensons que la facturation de l’inférence des modèles ne permettra pas de récupérer l’investissement dans l’infrastructure
Comme nous l’avons noté, les détracteurs du développement de l’IA soulignent les pertes actuelles des laboratoires, tandis que ses partisans mettent en avant les profits précoces, mais les uns comme les autres commettent la même erreur : confondre la période de transition avec l’équilibre. Nous n’en sommes encore qu’aux premières années de la transformation de l’économie par l’IA, et toute extrapolation naïve est erronée. À l’équilibre, tant le côté de l’offre que celui de la demande seront très différents de ce qu’ils sont aujourd’hui.
Voici quelques exemples des aléas rencontrés jusqu’à présent par les laboratoires d’IA : Un déploiement massif et spéculatif d’infrastructures qui était sans doute en avance sur la demande; le « moment Deepseek », durant lequel les modèles à poids ouvert ont failli rattraper la frontière; une flambée de la demande alors que les entreprises adoptaient les agents d’IA, souvent accompagnée de pratiques irrationnelles et gaspilleuses telles que les classements de jetons, menant à ce qu’on a appelé l’ère de la rareté des jetons; et, plus récemment, un nouvel élan en faveur d’un écosystème open source concurrentiel alors que les entreprises réévaluent leurs dépenses en modèles de pointe.
Ces hauts et ces bas présentent de nombreux parallèles avec les études de cas historiques mentionnées ci-dessus. Les chemins de fer ont d’abord connu une frénésie spéculative (la « manie des chemins de fer » des années 1840 en Grande-Bretagne). Aux États-Unis, au fil du temps, la demande a dépassé la capacité, ce qui a généré des rendements directs et indirects estimés à 15 % par année sur le capital ferroviaire jusqu’en 1860 — un chiffre énorme pour l’époque. Mais à mesure que le réseau se développait, la capacité a rattrapé la demande, la concurrence a comprimé les marges, et de nombreuses compagnies ferroviaires ont fait faillite.
Ainsi, pour mieux prévoir les perspectives à long terme des laboratoires, il est utile de prendre du recul par rapport aux fluctuations annuelles et trimestrielles des résultats financiers (et des discours), et d’ancrer notre analyse dans la théorie économique. Un concept clé est le paradoxe de Bertrand : celui-ci stipule que lorsque les entreprises vendent un produit homogène (inférence selon le modèle de la frontière), la concurrence sur les prix les obligera à vendre chaque unité (jeton) au coût marginal de production.
L’analyse théorique est importante, car la question de savoir dans quelle mesure les données historiques permettent de prédire l’évolution du secteur de l’IA fait l’objet de débats. Par exemple, notre collègue Mihir Kshirsagar identifie la réglementation comme la principale raison pour laquelle les entreprises ferroviaires, d’électricité et de télécommunications n’ont pas pu tirer profit de la plus-value générée par leur infrastructure, plutôt que de considérer cela comme une conséquence inhérente à leur modèle économique. Ainsi, la théorie nous donne une raison supplémentaire de nous attendre à un resserrement des marges. Bien qu’il soit facile d’échapper à ce paradoxe théorique dans la pratique, nous croyons que l’inférence des modèles recèle une version exceptionnellement pure des conditions qui engendrent ce paradoxe :
- les modèles sont largement indifférenciés. Au moins trois entreprises, OpenAI, Anthropic et Google, ont réussi à rester à la fine pointe et à produire des modèles dont le comportement et les performances sont similaires. De plus, pour une proportion croissante de cas d’utilisation, il n’est pas nécessaire d’atteindre des performances de pointe, et les modèles à poids ouverts sont suffisamment performants. De plus, la quasi-équivalence des modèles est facilement observable ou perceptible par les clients, car il existe des centaines de tests de performance sur lesquels les modèles sont régulièrement évalués, et les modèles de pointe ont tous tendance à se regrouper près du sommet.
- Pour un contraste révélateur provenant d’un autre secteur, Apple est réputé pour maintenir des marges élevées en échappant à cet aspect de la concurrence de Bertrand. Elle refuse de rivaliser sur des dimensions de performance objectivement observables (gigahertz, mégapixels), préférant mettre en avant les résultats et des qualités indescriptibles (« ça fonctionne, tout simplement ») et créant ainsi une forte différenciation de marque.
- Les fournisseurs ont tous des coûts d’investissement similaires. Les connaissances en IA se diffusent rapidement; les principaux paradigmes du développement de modèles — la mise à l’échelle des modèles, la mise à l’échelle de l’inférence, l’apprentissage par renforcement, etc. — ont tous évolué presque au même rythme. Ainsi, pour produire un jeton d’une qualité de sortie donnée, les laboratoires consacrent tous des montants similaires à l’entraînement. Dans un avenir hypothétique où la frontière ne progresserait pas aussi rapidement, les coûts seraient dominés par l’inférence, et les coûts d’inférence ont tendance à être encore plus homogènes que ceux de l’entraînement.
- Absence de différenciation géographique. Dans le cas des chemins de fer, une mosaïque de monopoles locaux et une capacité captive offraient une certaine protection contre la compression des marges. Le secteur de l’inférence en IA ne bénéficie pas de cette différenciation, et les entreprises peuvent effectivement desservir l’ensemble du marché. Bien qu’il existe sans doute aujourd’hui une contrainte de capacité symbolique, nous nous attendons à ce qu’elle soit temporaire.
- Les prix peuvent être modifiés librement, sans collusion. Les chemins de fer et les services publics ont pu s’entendre tacitement ou explicitement pour maintenir des prix élevés à certaines périodes de leur histoire. Mais cela est hautement improbable avec les modèles d’IA en raison de la concurrence féroce exercée par les modèles sous-frontaliers.
- Les coûts de transition sont minimes. Même les frictions liées à la migration des API sont largement éliminées par une couche d’outils de routage indépendants du fournisseur.1
Une réponse possible à tout cela consiste à affirmer que l’ampleur de la compression des marges n’a pas d’importance, car les entreprises d’IA compenseront simplement cette perte par le volume. Mais les chiffres ne tiennent pas la route. Si l’on suppose une marge nette de 5 % — bien supérieure à celle des compagnies aériennes — et la nécessité de récupérer les 4 T$ à 8 T$ d’investissement mentionnés plus haut sur un horizon de cinq ans, on aboutit à un besoin de revenus annuels de 16 T$ à 32 T$, dont la fourchette haute représente le quart du PIB mondial actuel.
Adopter cette perspective à long terme, fondée sur l’histoire et la théorie économique, nous permet de faire abstraction de plusieurs facteurs auxquels d’autres analystes ont tendance à accorder une importance cruciale. Pour l’instant, nous traversons une période où des cycles d’entraînement massifs et à forte intensité de capital continuent de produire de meilleurs modèles. Cela oblige les laboratoires à rester pris dans un cycle incessant de mises à niveau, dans lequel ils réinvestissent leurs revenus dans l’entraînement (et même davantage), en assumant des investissements toujours plus élevés. Lorsque ce cycle ralentira,2 le secteur atteindra un nouvel état d’équilibre qui sera probablement très différent de la situation actuelle. Dans cet état, trois facteurs qui dominent actuellement le débat auront beaucoup moins d’importance qu’ils ne le semblent aujourd’hui.
Le premier est la chute des prix des jetons, entraînée par des gains d’efficacité, que les critiques citent comme preuve d’une course vers le bas qui réduira la taille du gâteau. À notre avis, s’il est vrai que les prix des jetons ont chuté rapidement (et que cette tendance devrait se poursuivre), cela ne constitue pas nécessairement un problème pour les laboratoires. Selon la forme de la courbe de la demande, la libération de la demande pourrait plus que compenser la baisse des prix — c’est ce qu’on appelle le paradoxe de Jevons, selon lequel les gains d’efficacité entraînent une consommation accrue (et non réduite) d’une ressource.
Le deuxième facteur est la rareté des jetons, que les partisans invoquent comme preuve du pouvoir de fixation des prix des laboratoires. Toute rareté est toutefois probablement un phénomène temporaire qui sera atténué, voire éliminé, par une combinaison d’investissements dans l’infrastructure et d’améliorations algorithmiques. La rareté des jetons ne devrait donc pas permettre aux laboratoires d’augmenter leurs marges.
Le troisième facteur qui domine le débat actuel est la volonté de payer. Les détracteurs prédisent parfois que la demande s’évaporera lorsque les laboratoires mettront fin à leurs tarifs d’abonnement subventionnés, inférieurs au coût de production. Mais cela revient à considérer la volonté de payer comme une quantité fixe, quelque chose qui peut être extrapolée à partir de la situation actuelle. À long terme, nous nous attendons à ce que l’IA devienne un élément essentiel de la plupart des travaux intellectuels, et à ce que cette technologie soit aussi transformatrice que la révolution industrielle. Dans une transition de cette ampleur, la volonté de payer est potentiellement énorme.
En d’autres termes, il faut distinguer la création de valeur de la capture de valeur. Nous nous attendons à ce que la valeur créée soit d’une ampleur inimaginable. La question centrale — voire existentielle — pour les laboratoires est de savoir s’ils seront capables de capturer ne serait-ce qu’un faible pourcentage de cette valeur. Quelle fraction de la valeur que l’IA crée pour une entreprise cette dernière sera-t-elle prête à verser aux fournisseurs d’IA? Il ne s’agit pas d’un chiffre flottant, déterminé de manière exogène. Il dépend en grande partie de la capacité des laboratoires d’IA à échapper au piège de la banalisation.
Comme nous le démontrons ci-dessous, le moyen le plus fiable d’échapper au piège de la banalisation consiste à se positionner en aval de la chaîne de valeur économique (dans le cas de l’IA, cela signifie « remonter la pile »). Le passage de la vente d’infrastructures ou de produits physiques à des offres groupées incluant des services est parfois appelé «servitisation». Par exemple, à mesure que le matériel informatique se banalisait, IBM a réussi sa transition vers une entreprise de services, pour finalement vendre l’ensemble de sa division d’ordinateurs personnels à Lenovo. Les entreprises de télécommunications ont également déployé des efforts soutenus et intenses pour éviter de devenir de simples « tuyaux muets », mais sans succès. La valeur a plutôt été captée par les applications qui utilisaient l’infrastructure, ce qui a conduit à l’essor des géants de la technologie. Nous croyons que les laboratoires se trouvent aujourd’hui face à un choix similaire : capter la valeur dans les couches situées au-dessus des modèles, ou regarder d’autres créer des entreprises lucratives sur l’infrastructure qu’ils ont eux-mêmes construite et financée.
Comment les laboratoires réagissent-ils?
Pour résumer notre argumentation jusqu’à présent, notre analyse historique ainsi que la théorie économique suggèrent qu’il n’existe que deux voies plausibles pour sortir du piège de la banalisation : établir un contrôle quasi monopolistique sur le marché, ou capter la valeur aux couches supérieures de la pile, ce qui s’accompagne souvent de coûts de changement accrus.
Nous estimons que la première voie est peu probable et que le secteur restera concurrentiel. Les partisans de l’exceptionnalisme de l’IA pourraient ne pas être d’accord, prévoyant une évolution sans précédent historique : une discontinuité de capacité si spectaculaire qu’elle redessine entièrement le paysage concurrentiel. Dans ce scénario de « décollage brutal », un ou plusieurs laboratoires parviennent à une auto-amélioration récursive, rendant l’économie actuelle largement hors de propos.
Dans notre article complet, nous expliquons pourquoi ce scénario est hautement improbable. Pour l’instant, nous soulignons que de nombreux décideurs, investisseurs et autres intervenants hésitent à miser sur une telle possibilité et doivent plutôt se préparer à un scénario où celle-ci ne se concrétiserait pas.
Cela fait de la progression vers les couches supérieures de la pile la voie la plus probable à suivre. Nous estimons que les entreprises d’IA sont bien conscientes du piège de la banalisation; elles s’efforcent sans réserve de dépasser le statut de simples fournisseurs d’inférence (c’est-à-dire la vente de jetons indifférenciés par l’intermédiaire d’API de modèles) et cherchent à capter de la valeur aux couches supérieures de la pile. Nous n’en sommes qu’aux prémices de ces efforts et de nombreuses stratégies nouvelles et plus systématiques devraient voir le jour (nous en examinons certaines dans la section suivante). Mais déjà, certaines initiatives se dessinent.
- Des produits comme ChatGPT ou Claude Code se situent à une couche au-dessus des modèles. Les produits ne sont pas interchangeables comme le sont les modèles, pour une multitude de raisons techniques, contractuelles et comportementales, comme nous l’examinerons dans la section suivante. Dans le cas d’OpenAI, c’est ChatGPT, et non l’API d’OpenAI, qui représente depuis longtemps la majorité de ses revenus. Au début de 2026, les revenus d’Anthropic provenaient encore principalement de son API, mais avec la croissance explosive de Claude Code, cela pourrait ne pas durer bien longtemps.
- Le niveau suivant de la pile est celui du SaaS natif à l’IA, ou « intelligence en tant que service », et les laboratoires ont déjà pris des mesures précoces dans cette direction : la fonctionnalité « connaissances d’entreprise » de ChatGPT, et la vision d’Anthropic concernant les agents intégrés au système d’enregistrement. Cependant, c’est à ce niveau que les laboratoires sont les plus vulnérables face aux acteurs SaaS établis, notamment Microsoft.
- Les entreprises d’IA se lancent également dans le déploiement sur mesure et la refonte des flux de travail — par l’intermédiaire d’ingénieurs déployés sur le terrain et de partenariats avec des firmes de consultation. Cela ne s’intègre pas parfaitement dans la pile. Celle-ci suppose un équilibre dans lequel les milieux de travail ont été transformés par l’IA, alors que cette catégorie vise à monétiser la transformation elle-même.
- La voie la plus spéculative, et potentiellement la plus lucrative, pour la création de valeur se situe à la couche supérieure de la pile : l’idée d’agents d’IA en tant que « travailleurs numériques ». De nombreuses entreprises ont vanté cette idée. La première version d’une grande entreprise d’IA qui a été conçue pour fonctionner de manière analogue à un travailleur numérique plutôt qu’à un outil est peut-être Claude Tag, lancée en juin 2026. Un travailleur numérique intégré à chaque équipe d’une entreprise devient rapidement un réservoir de connaissances tacites pour l’ensemble de l’organisation et s’avère essentiel aux flux de travail et aux processus d’affaires entre les différentes équipes. À moins que la portabilité ne soit explicitement intégrée, il devient un employé numérique qui, en pratique, ne peut être congédié, créant ainsi un niveau de dépendance qui dépasse celui des logiciels d’entreprise dans le pire des cas. Lorsque les entreprises vendent des travailleurs numériques, le marché potentiel total correspond à l’ensemble des dépenses en main-d’œuvre de l’économie, ce qui est bien plus important que les budgets informatiques des entreprises. Mais c’est précisément pour ces raisons que cette vision risque de se heurter à la plus forte résistance de la part des entreprises.
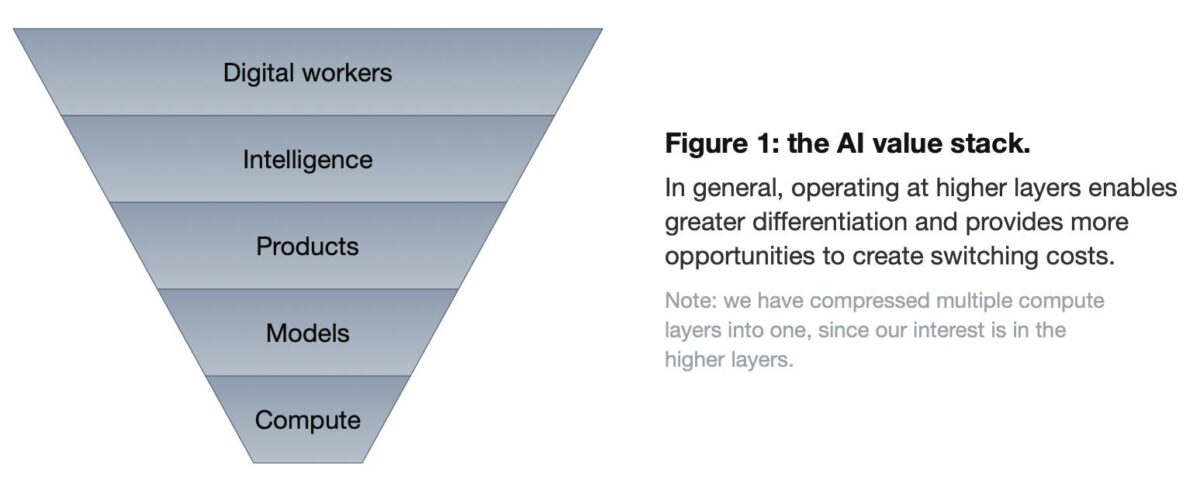
La figure 1 illustre certaines de ces initiatives en cours. Il est à noter que la pile décrit ce pour quoi le client paie, et non l’unité de facturation. La tarification par jeton peut être utilisée à n’importe quel niveau de la pile, et d’autres unités (abonnements, résultats) peuvent être utilisées en combinaison ou comme substituts aux niveaux supérieurs. C’est le type de valeur à chaque niveau de la pile qui détermine si le piège de la marchandise s’applique, et non le modèle de tarification. Nous abordons les stratégies de tarification plus en détail dans la section suivante.
L’une des principales conclusions de cet essai est que les entreprises qui opèrent à des niveaux supérieurs de cette pile peuvent capter une plus grande partie de la valeur qu’elles créent. Elles peuvent mieux différencier leurs offres et se doter de divers avantages concurrentiels (comme nous le verrons ci-dessous), dont bon nombre sont sans doute novateurs et plus puissants que ceux dont bénéficiaient les éditeurs de logiciels d’entreprise.
Une mise en garde importante : pour que les laboratoires d’IA, en particulier OpenAI et Anthropic, puissent gravir les échelons de la pile, ils doivent rivaliser avec des acteurs établis de plus grande envergure qui jouissent de nombreux avantages, notamment des canaux de distribution existants et des relations étroites avec la clientèle d’entreprise. Google bénéficie d’une intégration verticale aisée dans sa gamme existante de produits grand public. Les acteurs établis du SaaS, notamment Microsoft, parient qu’ils pourront s’approprier le modèle de l’« intelligence en tant que service » plus rapidement que les laboratoires d’IA. Cette inégalité redéfinit la dynamique concurrentielle de l’écosystème de l’IA et met en évidence des différences importantes entre les principaux acteurs qui tentent de gravir la chaîne de valeur.
La progression dans la chaîne de valeur ouvre la voie à un ensemble varié et puissant de fossés concurrentiels
Comment la progression dans la chaîne de valeur permet-elle aux entreprises d’échapper au piège de la banalisisation? La réponse ne réside pas simplement dans le fait que les couches supérieures créent davantage de valeur économique. Elle tient au fait qu’elles rendent cette valeur capturable et durable : opérer à un niveau supérieur de la chaîne de valeur permet aux laboratoires de différencier leurs offres et de créer des coûts de verrouillage et de changement inaccessibles aux vendeurs d’inférence brute, c’est-à-dire aux fournisseurs d’API. Elles permettent en effet aux entreprises d’IA d’échapper au manque de différenciation qui est au cœur du paradoxe de Bertrand. Les avancées dans la chaîne de valeur ne sont pas seulement de nouvelles stratégies de produits; ce sont des stratégies de création de barrières à l’entrée. Dans cette section, nous examinons plusieurs types de barrières à l’entrée — certaines que les laboratoires sont déjà en train de mettre en place, et d’autres qu’ils pourraient mettre en place à l’avenir.
Afin d’identifier les fossés qui s’ouvrent à mesure que les entreprises d’IA progressent au-delà de la couche des modèles, nous avons examiné comment les éditeurs de logiciels d’entreprise génèrent un pouvoir de fixation des prix et capturent de la valeur, puis nous avons analysé lesquelles de ces stratégies sont susceptibles de s’appliquer aux entreprises d’IA et quelles nouvelles stratégies deviennent disponibles.
Nous soulignons deux nuances importantes avant d’entrer dans le vif du sujet. Premièrement, bien que les avantages concurrentiels constituent des moyens de défendre sa part de marché face aux concurrents, notre intérêt réside dans l’analyse de la capacité des entreprises d’IA à capter la valeur qu’elles créent pour leurs clients. Néanmoins, les stratégies en jeu sont en grande partie les mêmes, car les deux cas exigent d’éviter une course à la baisse des prix.
Deuxièmement, notre analyse se concentre sur le marché des entreprises, car nous estimons qu’il représentera l’essentiel des revenus. OpenAI a récemment réorienté ses activités dans cette direction, tandis qu’Anthropic a toujours mis l’accent sur le secteur des entreprises. Bien qu’il soit possible que les produits grand public financés par la publicité constituent à l’avenir une source de revenus importante, contribuant ainsi à échapper au piège de la banalisation, cela ne remet pas en cause notre thèse concernant les avantages concurrentiels dans le secteur des entreprises.
1. Les avantages concurrentiels liés à l’intégration : Les modèles d’IA sont des éléments que les clients intègrent dans leurs flux de travail. Mais une autre vision de l’IA est celle d’un système dans lequel le client évolue. Cette dernière approche est plus propice à la création d’avantages concurrentiels.
Même si le modèle sous-jacent reste interchangeable, l’état qui l’entoure pour un client donné peut ne pas l’être. Au fil du temps, cet état s’accumule : mémoire persistante et historique des conversations, corpus de documents téléchargés et index de recherche, compétences personnalisées ou suites d’évaluation, flux de travail et processus d’affaires, ainsi que diverses formes de mise au point ou de personnalisation. Cette « gravité des données » contribue grandement à la fidélisation des utilisateurs des logiciels d’entreprise, et explique pourquoi leur remplacement a été qualifié de « chirurgie à cœur ouvert ».
Tant OpenAI (Company Knowledge) qu’Anthropic (Claude Cowork, le partenariat avec PwC) s’engagent déjà dans ces voies. La viabilité de ces stratégies reste toutefois une question ouverte. Une complication réside dans le fait que les données susceptibles de contribuer à la construction de ces « fossés » se trouvent généralement sur les serveurs des entreprises, au sein de systèmes bien établis comme Salesforce, Workday et SAP, qui sont en grande partie inaccessibles aux laboratoires d’IA. Pour surmonter cet obstacle, les entreprises d’IA pourraient se forger des « fossés » en contrôlant les couches d’orchestration occupées par les agents, fournissant ainsi le tissu conjonctif qui relie les flux de travail d’une organisation. Cependant, si les normes ouvertes maintiennent la couche d’orchestration légère et interchangeable, la valeur pourrait en fin de compte revenir aux intégrateurs d’agents et aux entreprises plutôt qu’aux laboratoires eux-mêmes.
2. Avantages concurrentiels écosystémiques : Les logiciels d’entreprise tels que Windows, GitHub et SAP ont tous tiré profit du fait que, à mesure qu’ils gagnaient davantage de clients ou de développeurs qui construisaient sur leur plateforme, la valeur de celle-ci augmentait. Le marché de l’IA ne présente pas encore de solides avantages concurrentiels liés à l’écosystème. Les laboratoires se sont efforcés de créer des marchés bilatéraux sur la base de l’IA en tant que plateforme, mais jusqu’à présent, ceux-ci ont soit échoué (GPT Store), soit été trop limités pour générer des coûts de changement significatifs (plugines Claude).
Un type d’effet de réseau très discuté mais pas encore concrétisé est le «flywheel» (effet de roue d’inertie) lié à l’entraînement de modèles ou de systèmes d’IA à l’aide de la propriété intellectuelle des clients, qu’il s’agisse de données, des environnements dans lesquels les agents s’exécutent, des traces d’exécution de ces agents ou de suites d’évaluation privées. Jusqu’à présent, les entreprises se sont montrées réticentes à laisser leur propriété intellectuelle être utilisée de cette manière par les développeurs d’IA, mais cela pourrait changer à l’avenir. Après tout, il suffit qu’un seul client (adéquatement incité) dans chaque secteur change de fournisseur pour mettre un effet de volant d’inertie en marche.
3. Avantages concurrentiels commerciaux : Cette catégorie englobe toute une gamme de stratégies bien connues, largement empruntées aux logiciels d’entreprise et au cloud computing. Les contrats commerciaux peuvent inclure divers mécanismes (ententes pluriannuelles, paliers de dépenses engagées, crédits prépayés) qui rendent le passage à la concurrence non rentable. Les laboratoires déploient déjà certains de ces mécanismes dans leurs ententes d’entreprise, mais la pérennité de ce fossé est également discutable. Les équipes d’approvisionnement d’entreprise averties exigeront la portabilité avant de signer, et le verrouillage contractuel est très facilement identifiable par les autorités antitrust.
L’intégration verticale offre une version plus puissante de cette même logique commerciale. Lorsqu’un assistant d’IA est intégré à un logiciel pour lequel une entreprise paie déjà (Copilot dans Microsoft 365, Gemini dans Google Workspace), le coût marginal de l’IA semble être nul, ce qui rend difficile pour les concurrents autonomes de rivaliser sur le plan des prix. Les acteurs intégrés peuvent également tirer parti des relations existantes en matière de ventes et d’approvisionnement : au lieu de remporter une nouvelle ligne budgétaire, ils intègrent simplement l’IA dans une discussion de renouvellement concernant un logiciel auquel le client s’est déjà engagé. Bien sûr, cette stratégie n’est accessible qu’aux acteurs établis et intégrés comme Google et Microsoft. Comme indiqué plus haut, cela signifie que les laboratoires autonomes comme OpenAI ou Anthropic doivent rivaliser sur un terrain de jeu structurellement inégal, louant souvent de l’infrastructure aux entreprises mêmes contre lesquelles ils sont en concurrence.
4. Les avantages comportementaux : Alors que les avantages évoqués plus haut reposent sur des mécanismes techniques ou commerciaux, les fossés comportementaux s’appuient sur les utilisateurs des systèmes d’IA. Tout comme les vagues précédentes de logiciels d’entreprise (Microsoft Excel, les systèmes CRM), l’utilisation d’outils d’IA peut entraîner une érosion de la capacité à accomplir des tâches sans aide, tout en développant simultanément des compétences spécifiques au fournisseur pour l’utilisation de produits autonomes, ce qui crée une dépendance. Il s’agit d’un domaine où les enjeux sociétaux peuvent être considérables, au-delà de ses implications en matière de captation de valeur : l’érosion des compétences pourrait avoir des répercussions profondes sur la résilience de la main-d’œuvre, la sécurité et la répartition du pouvoir entre les personnes et les systèmes d’IA.
Mais les « avantages concurrentiels comportementaux » englobent également des formes nouvelles et mal comprises de verrouillage par l’IA qui n’ont pas d’équivalent clair dans les logiciels antérieurs. Une manifestation notable en est l’attachement relationnel au ton ou à la « personnalité » d’un modèle, comme l’a démontré de façon frappante la réaction négative #Keep4o, lorsque OpenAI a été contraint de réintégrer GPT-4o en réponse aux demandes des utilisateurs. De manière plus spéculative, pour les travaux collaboratifs de connaissance tels que la rédaction ou les tâches nécessitant un jugement important (par opposition à l’automatisation), la qualité de la contribution de l’IA est difficile à vérifier pour l’acheteur, même a posteriori, car il n’existe pas de normes objectives. Cela fait de ce type de travail ce qu’on appelle un bien de confiance, à l’instar des services d’avocats et de consultants. Incapables de comparer la qualité, les acheteurs de biens de confiance ont tendance à se fier à la réputation et à la confiance. Cela atténue la concurrence sur les prix et ralentit les changements de fournisseur, même lorsque le coût technique d’un tel changement est proche de zéro.
5. Stratégies de tarification : Cette voie est complémentaire ou s’ajoute à celles évoquées ci-dessus, et décrit un moyen par lequel les laboratoires pourraient être en mesure de capter davantage de valeur après avoir atteint un effet de verrouillage et être en mesure d’exercer un pouvoir de fixation des prix. L’idée est que les laboratoires pourraient surmonter le piège de la banalisation en facturant les résultats (un pourcentage des économies réalisées, des frais par demande d’assistance résolue) plutôt que des jetons. C’est la thèse explicite qui sous-tend la déclaration de Sarah Friar, directrice financière d’OpenAI, selon laquelle les revenus devraient «évoluer proportionnellement à la valeur de l’intelligence».
Cependant, cela semble peu probable à court terme. La tarification à la performance nécessite de résoudre un problème de mesure complexe. Les laboratoires n’ont pas mis en place l’infrastructure nécessaire pour mesurer et comprendre les processus d’affaires de leurs clients, ni pour suivre — et encore moins tarifer — les différents résultats. Sans cette visibilité, les indicateurs de performance s’ouvrent à des abus de part et d’autre : des frais par ticket résolu incitent les clients à regrouper plusieurs problèmes dans un seul ticket et les fournisseurs à clore les tickets sans nécessairement les résoudre. De plus, les résultats varient d’un secteur à l’autre et d’une entreprise à l’autre, et les laboratoires d’IA ne disposent pas des équipes client intégrées que les fournisseurs de SaaS ont mis des décennies à mettre en place afin d’acquérir ce type de visibilité en aval. Néanmoins, certaines entreprises d’IA tentent d’innover sur ce front. Si les laboratoires d’IA parviennent à migrer vers des systèmes d’enregistrement, ces défis deviendront surmontables avec un investissement suffisant.
Abonnez-vous pour recevoir une analyse fondée sur des données factuelles des répercussions de l’IA
Les répercussions plus larges de cette évolution
Les questions soulevées par notre analyse ont une incidence significative sur l’avenir de l’économie de l’IA, mais elles s’étendent bien au-delà des perspectives de n’importe quelle entreprise d’IA prise isolément. Elles touchent à la structure des marchés numériques, à la répartition du pouvoir économique et au type d’écosystème d’innovation que l’IA est susceptible de générer.
Si les laboratoires ne parviennent pas à échapper au piège de la banalisisation, les conséquences seront avant tout financières : une crise de confiance potentielle dans l’un des plus importants déploiements de capitaux de l’histoire économique, avec des répercussions sur l’ensemble du secteur technologique et les marchés en général. Mais s’ils y parviennent — en particulier s’ils réussissent à augmenter les coûts de changement de fournisseur et à fidéliser leur clientèle —, les conséquences s’annoncent différentes, et à certains égards plus préoccupantes. Cela ferait grimper les coûts pour toutes les entreprises qui dépendent de l’IA et consoliderait la position d’un petit nombre d’acteurs bénéficiant d’un avantage structurel qu’il sera difficile de contester par la suite.
Quelques questions en particulier méritent d’être prises au sérieux dès maintenant, avant que les fossés concurrentiels ne se soient solidifiés :
- Les laboratoires peuvent-ils bâtir des entreprises durables sans étouffer la concurrence et sans reproduire les schémas antérieurs de concentration néfaste?
- Les stratégies qui fonctionnent pour les investisseurs et les entreprises d’IA peuvent-elles également générer une valeur sociale plus large, ou la capture de valeur dans le domaine de l’IA se fait-elle au détriment de l’écosystème environnant?
- Les retombées de l’IA seront-elles diffusées (profitant principalement aux entreprises qui la déploient et à l’économie dans son ensemble) ou concentrées (captées en grande partie par les hyperscalers, les laboratoires d’IA de pointe, les acteurs établis du SaaS et les investisseurs)?
Une grande incertitude subsiste quant à ces questions, mais l’histoire suggère qu’il faut établir dès maintenant les normes d’interopérabilité, les exigences de portabilité et la transparence des coûts de changement de fournisseur, avant que le verrouillage ne s’aggrave et que toute intervention ne devienne structurellement plus difficile. Heureusement, les autorités de la concurrence telles que la FTC américaine et la CMA britannique surveillent ce secteur, mais jusqu’à présent, elles semblent avoir concentré leur analyse sur les couches inférieures de la pile technologique. Notre analyse montre qu’elles doivent élargir leur champ de vision.
Nous remercions Sayash Kapoor pour ses commentaires sur une ébauche de ce texte.
Lectures complémentaires
Bien que de nombreux aspects de notre argumentation soient au moins quelque peu novateurs, l’argument de l’« absence de fossé » n’est pas nouveau en soi. Sa première formulation marquante (à notre connaissance) remonte à plus de trois ans, dans un document de Google qui a fait l’objet d’une fuite. De nombreux commentateurs, tels que Gary Marcus, Ed Zitron et Cory Doctorow, n’ont cessé de faire valoir ce point ou des variantes de celui-ci.
Ce qui est peut-être nouveau dans notre analyse, c’est de nous appuyer sur des parallèles historiques et de montrer que l’inférence des modèles correspond encore mieux aux conditions préalables d’une concurrence ruineuse que ne le font ces précédents. Là où nous nous distinguons clairement de ceux qui prédisent une bulle, c’est en reconnaissant que (1) la pile d’IA est assez épaisse et que le piège de la banalisisation ne s’applique qu’à la couche des modèles, (2) les laboratoires sont parfaitement conscients du problème et (3) s’efforcent désespérément de s’en sortir.
Beaucoup d’autres se montrent pessimistes à l’égard des laboratoires, notamment Benedikt Evans et Luis Garicano et Jesús Saa-Requejo. Ces derniers soutiennent que la capture de valeur se fera à la fois au sommet de la chaîne de valeur, chez les fournisseurs de matériel et d’infrastructures physiques [en raison du goulot d’étranglement informatique], et au niveau de la couche de mise en œuvre, où les modèles sont mis à contribution et où la contrainte déterminante est d’ordre organisationnel, et non technique. Nous sommes largement d’accord. Mais ils concluent que les laboratoires ne seront pas en mesure de capter beaucoup de valeur. L’hypothèse implicite semble être que les laboratoires se limitent à être des fournisseurs de modèles, ce qui, à notre avis, est une notion de plus en plus dépassée.
Semianalysis soutient que les laboratoires seront en mesure de maintenir des marges brutes élevées en raison de la rareté des ressources de calcul. Nous pensons qu’il s’agit d’une situation temporaire.
Celui dont la réflexion se rapproche le plus de la nôtre est notre collègue du CITP de Princeton, Mihir Kshirsagar, qui a rédigé une série de quatre articles sur ce sujet. Bien que nous ayons tiré profit de nos échanges avec Kshirsagar, notre réflexion s’est développée en grande partie de manière indépendante, avec de nombreux points de convergence et quelques points de divergence. Tout comme M. Kshirsagar, nous pensons que le développement rapide de l’IA n’aurait aucun sens sur le plan économique s’il n’y avait pas la promesse d’un effet de verrouillage. Son analyse identifie les alliances entre les hyperscalers et les laboratoires d’IA (telles que Microsoft-OpenAI et Amazon-Anthropic) comme le principal vecteur de cet effet de verrouillage, ce qui diffère légèrement de notre diagnostic.
Nathan Lambert propose une vision de la façon dont tout cela pourrait se dérouler : une économie de l’IA à deux vitesses dans laquelle les clients, qui se situent eux-mêmes à la fine pointe du travail intellectuel, paieraient des primes élevées pour des produits et services « en amont de la chaîne » basés sur les modèles de pointe des principaux laboratoires, tandis que tous les autres se contenteraient de l’écosystème des modèles ouverts. L’une de ses prédictions est plus précise que la nôtre : les laboratoires de pointe laisseront leurs activités liées aux API se dégrader afin de protéger leurs offres à plus forte marge.
Le modèle théorique qui sous-tend le paradoxe de Bertrand est un jeu à une seule manche, et les coûts de changement n’entrent pas en ligne de compte; mais bien sûr, dans la pratique, il faut en tenir compte.
Cela ne veut pas dire que l’IA cessera de progresser — d’autres pistes, telles que l’évolutivité de l’inférence et l’amélioration des outils, resteront d’actualité.
Liste évolutive des articles traduits par Gilles en vrac
Les caractères gras dans le texte sont de l’auteur.e et de Gilles